「纸上留影」Codex Skill 把一张照片做成竖版作品:上面是照片,下面是一幅纸上版画(纸上北京系列)
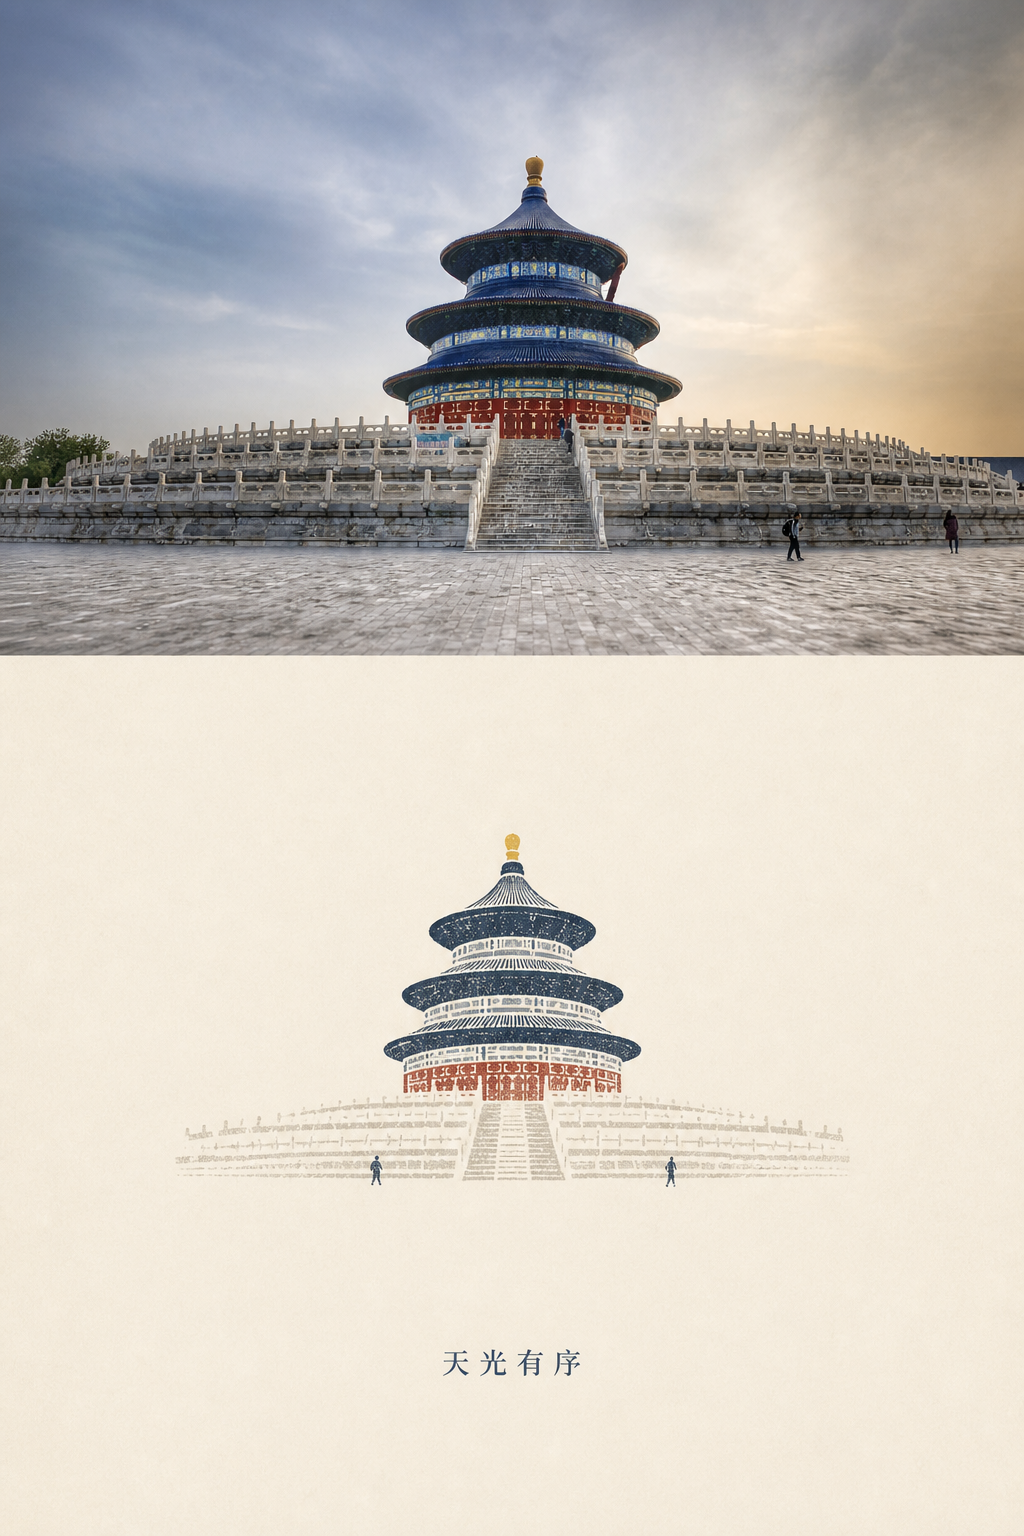
吴昊阳(GitHub @wnby)开源的 Codex 图像创作 Skill(MIT):给一张照片,让 Codex 调用图像生成工具出一张竖版作品——上半部分是原照片,下半部分是从照片里提炼出的极简「纸上版画」(建筑轮廓、几块深蓝油墨、一点暖色、小标题)。仓库附 6 张「纸上北京」样例(天坛、角楼、鸟巢、中国尊、长城、雁阵)。中文社区 @xunana1017 于 11-01 撰文推荐。我们克隆仓库,通读 SKILL.md 与参考提示词、检查 6 张样例图;没有在 Codex 里实际生成新图。
访问官网 Photo Relic Editorial(wnby/photo-relic-editorial) ↗- 定价
- 免费
- 地区
- 海外
- 出自哪里
- 中文社区
- 上架日期
- 2026 年 11 月 3 日
- 实测日期
- 2026 年 11 月 3 日
- 用的版本
- wnby/photo-relic-editorial commit 2232da1 (2026-08-05); not run in Codex
- 原作者
- 吴昊阳 (wnby) ↗
- 我们实测
- 部分实测
- 成本 / 耗时
- Skill 本身 MIT 免费;出图消耗你 Codex / ChatGPT 套餐里的图像生成额度。
要解决的事
把旅行/城市照片做成风格统一、能成系列发小红书/抖音封面的「照片 + 抽象版画」竖图,而不是让 AI 把整张照片重画。
步骤
- 安装:`npx skills add https://github.com/wnby/photo-relic-editorial --skill photo-relic-editorial`;或把仓库里的 photo-relic-editorial 文件夹复制到 `~/.codex/skills/`(Windows 为 `%USERPROFILE%\.codex\skills\`),然后重启 Codex。
- 准备一张自己拍的、主体轮廓清楚的照片(古建、地标、天际线、桥、倒影、人群队列效果最好)。
- 在 Codex 里附上照片,粘贴下方提示词。要中文系列可加一句:Make it feel like the "Paper Beijing" series, with a short four-character Chinese title.
- Skill 会先从照片里挑 3–5 个线索(主体、情绪、主色、光向、结构),选好版式/笔触/标题方式,再调用图像工具生成一张竖图。
- 按 SKILL.md 的 Quality Gate 自查:缩略图里能认出主体、版画颜色来自原图、标题很小、没有水印/贴纸;明显不合格就让它按失败点重生成一次。
- 要做系列就固定同一套配方(纸色、墨色、标题方式),逐张换照片。
提示词
Use $photo-relic-editorial to turn this photo into a Photo Relic artwork. Make it feel like the "Paper Beijing" series, with a short four-character Chinese title.
原文怎么说
@xunana1017:审美在线;不替代真实照片,而是从照片里提炼建筑轮廓、光影、颜色和情绪,压成一幅带纸张质感的极简版画;有明确质量检查(主体必须可辨认);适合旅行摄影、社媒封面、城市系列。作者 README:上半部分保留真实照片,下半部分生成可识别、克制的「纸上留影」。
我们实测
克隆 wnby/photo-relic-editorial(commit 2232da1,2026-08-05),用 PyYAML 解析 SKILL.md frontmatter(name/description 正常),通读 146 行 SKILL.md 与 156 行 references/afterimage-editorial-prompt.md、agents/openai.yaml;检查 examples/paper-beijing 下 6 张 PNG 的尺寸与元数据,并查看天坛样例。没有在 Codex 里安装 Skill,也没有用自己的照片生成新图。
我们亲自试下来:SKILL.md 写得很具体:先挑 3–5 个原图线索,再从 5 个维度(版式、笔触语法、线条重量、标题方式、动态种子)各选一项,最后有 10 条质量检查,不合格只重生成一次。6 张样例都是 1024×1536,内嵌 C2PA 声明「gpt-image 创建、trainedAlgorithmicMedia」——说明上半部分的“真实照片”也是模型重绘。天坛样例里上下两部分对得上,下半部分保留了三层蓝顶、红墙、台阶和两个小人,确实缩略图也认得出。
怎么用上
GitHub 仓库公开,README 中英双语。需要能用 Codex(ChatGPT 账号)及其图像生成;推荐帖是 X 长文,需登录 X 查看。
适合谁
有一批旅行/城市照片、想做风格统一的系列封面或小红书图文的人;已经在用 Codex 的设计爱好者。
踩坑提示
- 它只是一份 SKILL.md + 参考提示词,不是图片处理软件;真正出图靠 Codex 里可用的图像生成工具,没有就用不了。
- 「上半部分保留原照片」是写给模型的要求,不是像素级拼接:我们检查 6 张样例,都是 1024×1536,C2PA 元数据标注由 gpt-image 生成(trainedAlgorithmicMedia),也就是上半部分照片同样是模型重新渲染的。要百分百保真,应自己用原图把上半部分替换回去。
- 主体轮廓不清、细节杂乱的照片(室内、近景人像)不在作者推荐范围里,效果难保证。
- 仓库最后一次提交是 2026-08-05,推荐帖属于老项目再传播;Skill 不依赖版本更新,但别期待作者近期迭代。
- 只用自己拍摄或有权使用的照片;生成图带 AI 来源元数据,商用前确认平台对 AI 图的标注要求。
配图
同类用例
- 一张自拍做出一套透明底动态表情包图像生成Seedream 5.5即梦花叔 SkillSkill 开源;生图按即梦积分◐ 部分实测国内
- 两分钟给 Agent 接上 GPT 生图与 GIF图像生成openai-imageMCPGrok BotMCP 免费;出图走 OpenAI 额度◐ 部分实测海外
- 一句话批量转 WebP、裁白边图像生成image-processingClaude CodePillow技能免费;需 Claude Code + Pillow◐ 部分实测海外
- 一刀版上色,折出带 Fold 动画的低模 GLB图像生成OrigamiClaude CodeBlender技能免费;上色约 $0.1–0.25/件◐ 部分实测海外
- 像素特效全用代码写,Claude 还能照流程做新的图像生成pixelfxClaude Code像素特效库与技能免费;新做需 Claude◐ 部分实测海外